Curso en UTN Rosario y TheLab Technology
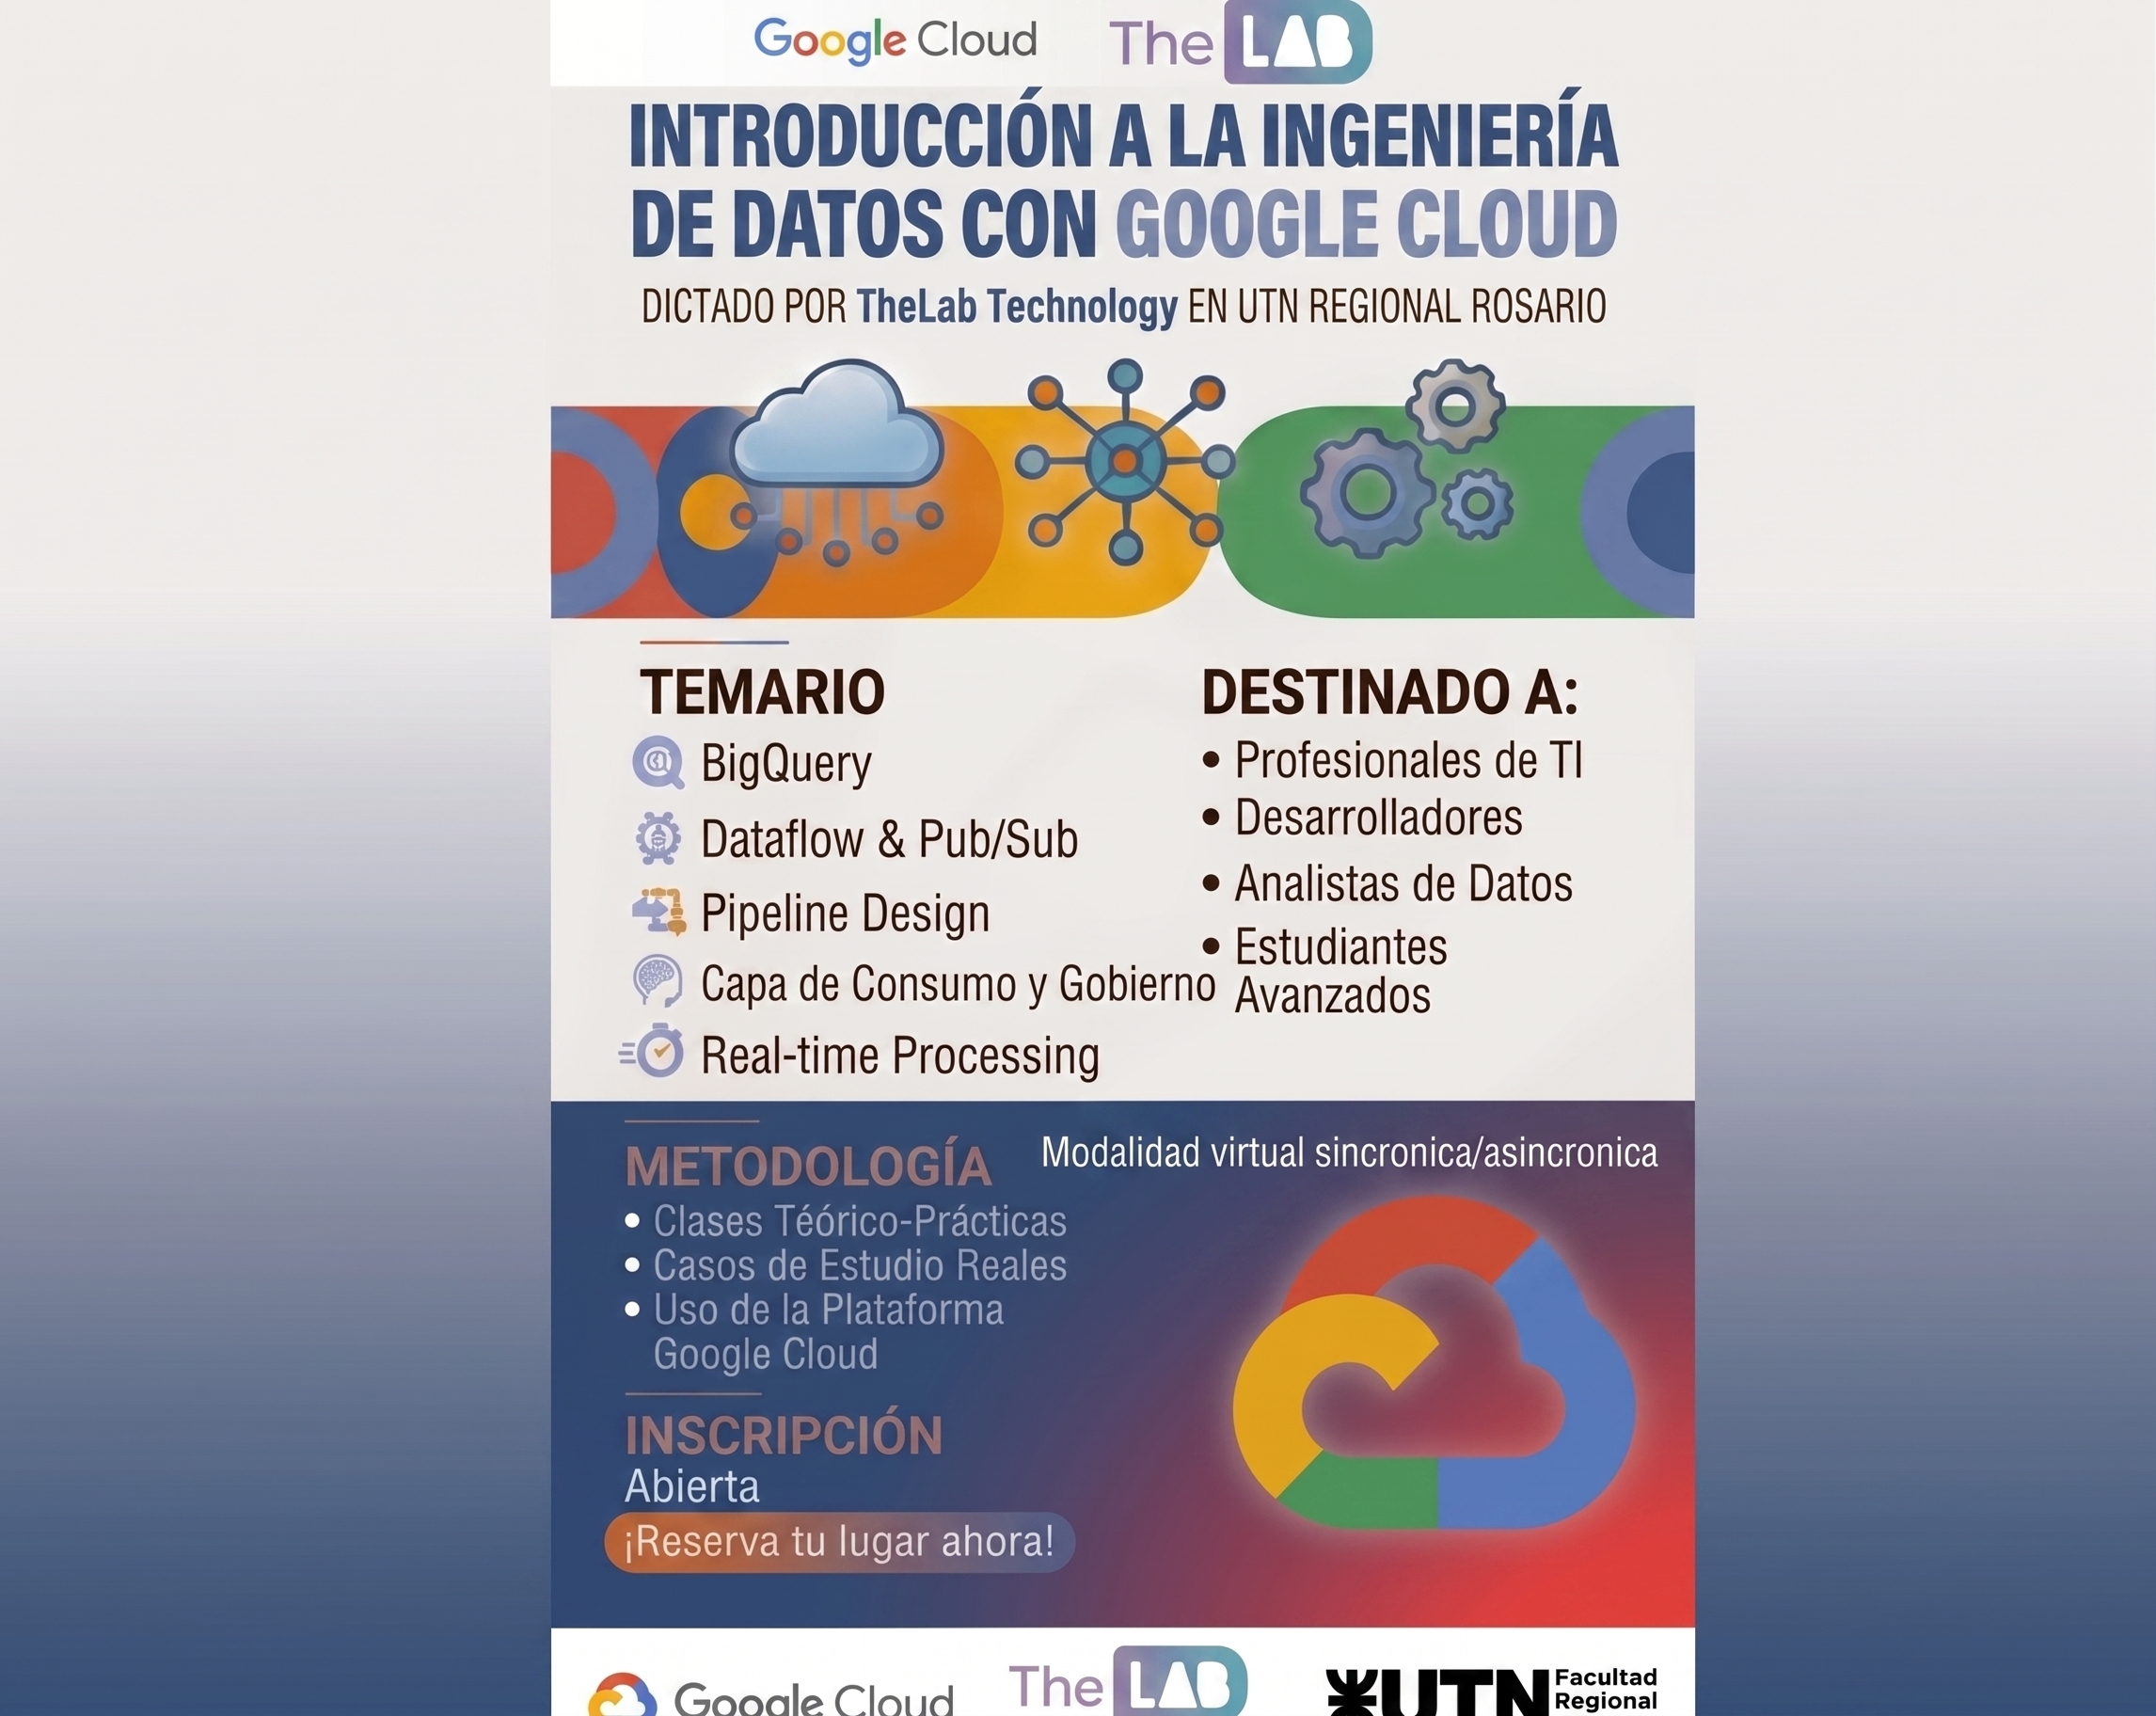
Introducción a la Ingeniería de Datos con Google Cloud
Objetivo del programa
Que el estudiante construya, de punta a punta, una plataforma analítica moderna sobre Google Cloud: desde la ingesta del dato crudo hasta su explotación, aplicando las prácticas que se usan hoy en la industria — modelado dimensional, transformación versionada en Git, testing de calidad de datos y automatización.
El curso se apoya en un trabajo práctico integrador que cada estudiante desarrolla en su propio repositorio de GitHub y que se corrige al finalizar, de modo que el egresado termina con un proyecto demostrable en su portfolio.
Clase 1 · Fundamentos y primer contacto con BigQuery
- El rol del ingeniero de datos y el ciclo de vida del dato
- OLTP vs. OLAP: por qué existe el data warehouse
- ETL vs. ELT y arquitectura por capas (raw → staging → marts)
- Panorama de Google Cloud: proyectos, IAM, Cloud Storage
- Práctica: consultas sobre datasets públicos de BigQuery, lectura del plan de ejecución y del costo
Clase 2 · BigQuery en profundidad e ingesta de datos
- Arquitectura: separación de storage y compute, modelo columnar, modelo de precios
- Particionado y clustering: criterios de diseño e impacto medible en costo
- Tipos anidados y desnormalización
- Ingesta: carga batch desde Cloud Storage, tablas externas, CLI y cliente Python
- Práctica: carga del dataset propio a la capa raw
Clase 3 · Modelado y transformación
- Modelado dimensional: hechos, dimensiones, granularidad, esquema estrella
- SQL analítico: CTEs, window functions, deduplicación
- Transformación versionada con dbt sobre BigQuery: modelos, referencias, materializaciones
- Por qué la lógica de negocio vive en el repositorio y no en la consola
- Práctica: construcción de la capa staging y del primer modelo de negocio
Clase 4 · Calidad de datos, orquestación y automatización
- Testing de datos: unicidad, integridad referencial, valores esperados, frescura
- Orquestación: consultas programadas, Cloud Scheduler y Cloud Run Jobs
- Introducción a la integración continua aplicada a datos
- Buenas prácticas de repositorio: ramas, pull requests, revisión entre pares
- Práctica: pipeline programado con tests en verde
Clase 5 · Consumo, gobierno de datos y cierre
- Capa de consumo: vistas autorizadas y visualización en Looker Studio
- Gobierno: permisos por dataset, políticas de columna, catálogo y linaje
- Optimización de costos en BigQuery y anti-patrones frecuentes
- Panorama de procesamiento en tiempo real
- Presentación de los trabajos prácticos y devolución
Metodología
El Curso dispone de una Parte Teorica y una práctica en modalidad taller ( Optativa ).
Modalidad taller: cada encuentro combina una exposición conceptual breve con construcción en vivo sobre uncaso real.
Los estudiantes en caso de optar por la modealidad taller como complemento de la clase teórica replican el desarrollo sobre su propio dataset y versionan cada avance en GitHub, de
forma que el trabajo práctico crece semana a semana y no se concentra al final.
Se entrega un módulo introductorio asincrónico de configuración de entorno, a completar antes del primer encuentro, para que el tiempo de clase se destine íntegramente al contenido.
Prerrequisitos: SQL básico, Python básico y manejo elemental de Git. Todo el curso se desarrolla dentro de la capa gratuita de Google Cloud. Se otorgará certificado de asistencia y Aprobacion con la finalización del trabajo práctico.
Modalidad Teórica: Se otorgara certificado de asistencia con la participación del curso y en caso de corresponder de aprobación práctica.
Modalidad: Virtual Sincrónica y Asincrónica.
Fecha de Inicio: Primer semana de Octubre.
Cupos limitados sujetos a evaluación y disponbilidad.
Inscripcion para Estudiantes de UTN: Acceder al Formulario de postulacion a Beca
Inscripcion para Empresas: Acceder al Formulario Inscripcion Empresas